


 Drupal CMS ラボ 編集部


この記事は Dries Buytaert 氏の公式ブログ「dri.es」の翻訳記事です。Driesブログの記事一覧よりすべての翻訳記事をご覧いただけます。
ローカルの大規模言語モデル(LLM)は正確なaltテキストを生成できるのか、それともクラウドサービスのほうがまだ優れているのか?
4ヶ月前に10種類のローカルビジョンLLMをテストし、主要なクラウドモデルと比較しました。ビジョンモデルは画像を分析してその内容を説明できるため、altテキストの生成に活用できます。
結果はどうだったか。ローカルモデルは重要な細部を見逃したり、ハルシネーション(誤った情報の生成)を起こしたりしていました。そこでクラウドモデルに切り替えたところ精度は上がりましたが、プライバシーとオフライン利用の利点を犠牲にする形になりました。
2週間前、Ollamaがビジョンモデルへの対応を強化したバージョン0.7.0をリリースしました。今回追加された3つのビジョンモデルは、これまでテストしていないものです。Mistral 3.1、Qwen 2.5 VL、Gemma 3です。
これらのモデルがGPT-4やClaude 3.5に追いついたのか評価することにしました。ローカルモデルで正確かつ信頼性の高いaltテキストを生成できるようになったのでしょうか?
| モデル | 提供元 | リリース日 | モデルサイズ |
|---|---|---|---|
| Gemma 3 (27B) | Google DeepMind | 2025年3月 | 27B |
| Qwen 2.5 VL (32B) | Alibaba | 2025年3月 | 32B |
| Mistral 3.1 (24B) | Mistral AI | 2025年3月 | 24B |
altテキスト生成スクリプトのアップデート
以前の実験では、altテキストの説明を生成するオープンソーススクリプトを作成しました。このスクリプトはOllama、Hugging Face、各種クラウドプロバイダーのモデルに対応した統一インターフェースを提供するSimon Willison氏のllmツールのPythonラッパーです。
新しいモデルをテストするために、各モデルのプロンプト、温度、トークン設定を定義するスクリプトのmodels.yamlに3つのエントリを追加しました。設定が完了すれば、altテキストの生成はシンプルです。3つの新しいビジョンモデルを使った例を示します。
$ ./caption.py test-images/image-1.jpg –model mistral-3.1-24b gemma3-27b qwen2.5vl-32b出力は次のようになります。
{
  "image": "test-images/image-1.jpg",
  "captions": {
    "mistral-3.1-24b": "A bustling intersection at night filled with pedestrians crossing in all directions."
    "gemma3-27b": "A high-angle view shows a crowded Tokyo street filled with pedestrians and brightly lit advertising billboards at night.",
    "qwen2.5vl-32b": "A bustling city intersection at night, crowded with people crossing the street, surrounded by tall buildings with bright, colorful billboards and advertisements.",
  }
}
モデルの評価
結果の一貫性を保つため、以前のブログ記事と同じテスト画像・評価方法を使用しました。詳細な結果はGoogleスプレッドシートにまとめています。
各altテキストは3つの基準(画像の最も重要な要素をどれだけ特定できているか、雰囲気や情景をどれだけ的確に捉えているか、繰り返しや文法的な問題・ハルシネーションを避けられているか)に基づいて0〜5点で採点し、AからFの評価に換算しました。
比較として、クラウドモデルのスコアは以下の通りです。GPT-4oが平均4.8/5(A評価)、Claude 3.5 Sonnetが満点の5/5(A評価)でした。
テスト画像1:東京・渋谷交差点
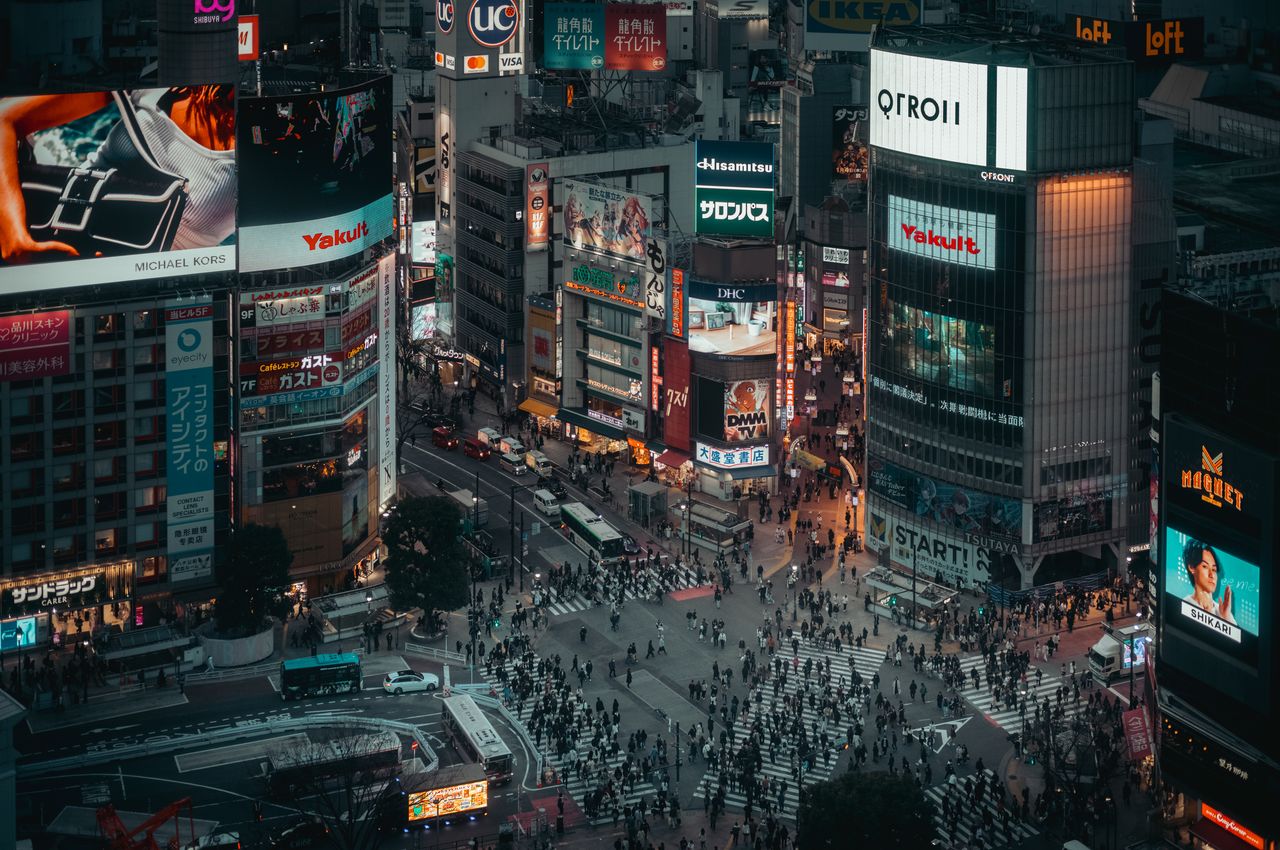
| モデル | 説明文 | 評価 |
|---|---|---|
| Mistral 3.1 (24B) | A bustling intersection at night filled with pedestrians crossing in all directions. | C |
| Gemma 3 (27B) | A high-angle view shows a crowded Tokyo street filled with pedestrians and brightly lit advertising billboards. | B |
| Qwen 2.5 VL (32B) | A bustling city intersection at night, crowded with people crossing the street, surrounded by brightly lit billboards and tall buildings. | B |
クラウドモデルは東京の渋谷交差点と特定できますが、どのモデルもここまで識別できなかったためA評価には届きませんでした。MistralはさらにLED看板も見逃しています。
テスト画像2:ボストン・イザベラ・スチュワート・ガードナー美術館
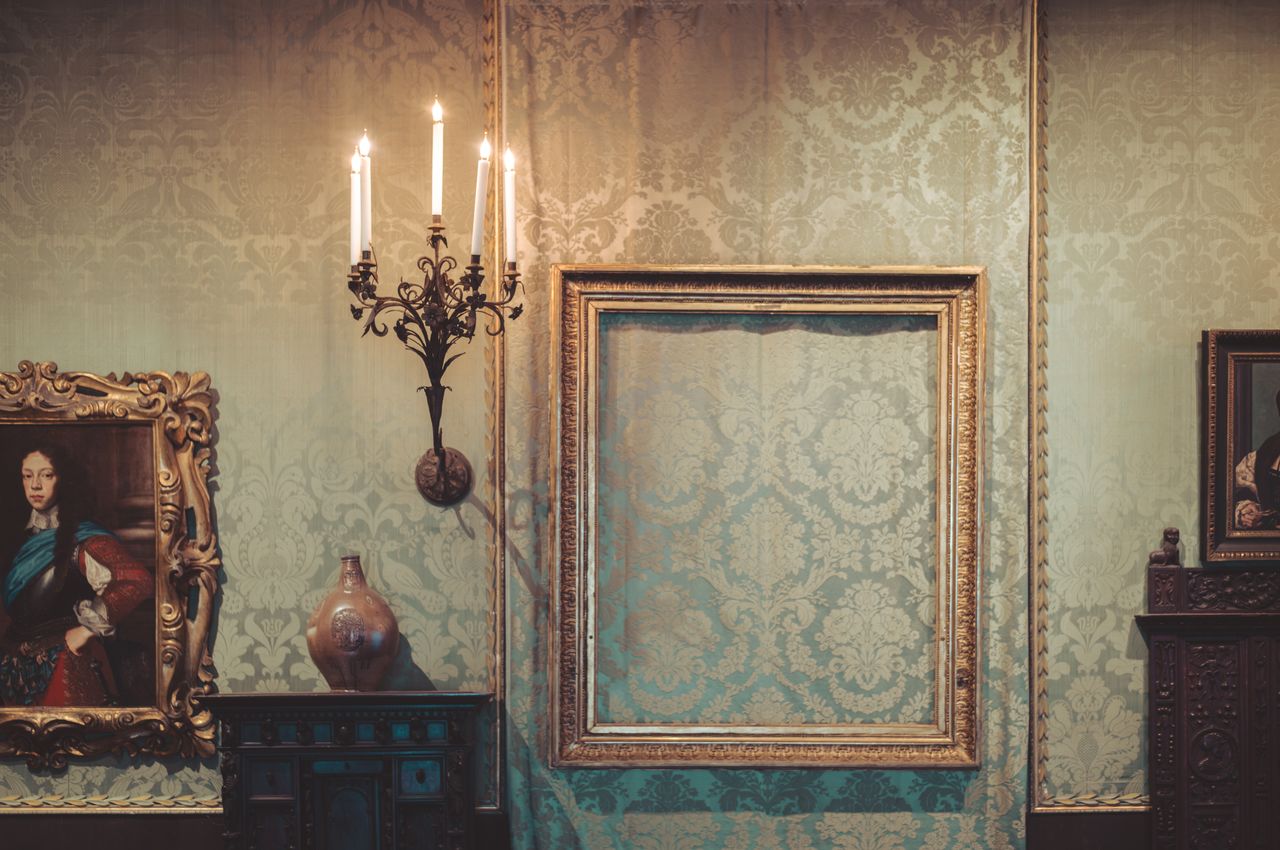
| モデル | 説明文 | 評価 |
|---|---|---|
| Mistral 3.1 (24B) | An ornate wall features a large empty picture frame. | B |
| Gemma 3 (27B) | An empty, ornate gold frame hangs on a patterned green wall between two framed portraits and a candle sconce. | A |
| Qwen 2.5 VL (32B) | A vintage-style room features ornate wallpaper, a framed empty canvas, a lit candelabra, and a decorative vase on a table, with portraits on either side. | A |
以前のテストのビジョンモデルは空の額縁を絵画として誤認することが多かったのですが、今回の3モデルはすべて正確に「空」と識別しました。GemmaとQwenはシーンの細部まで的確に捉えており、Mistralの説明は少し物足りない印象でした。
テスト画像3:バーモント州でのウェイクボード
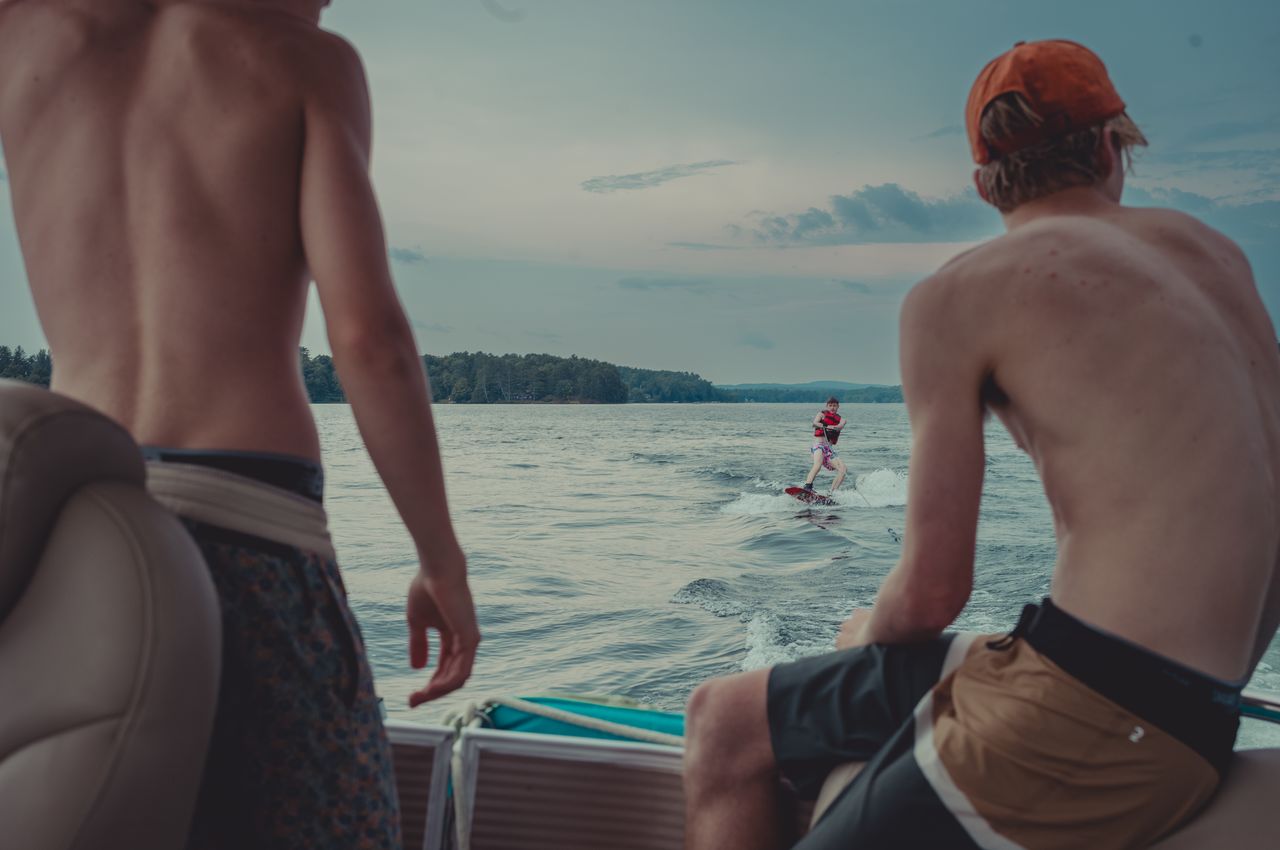
| モデル | 説明文 | 評価 |
|---|---|---|
| Mistral 3.1 (24B) | Two shirtless men on a boat watch another person water skiing on a lake. | B |
| Gemma 3 (27B) | Two people on a boat watch a waterskier speeding across the lake on a sunny day. | B |
| Qwen 2.5 VL (32B) | Two shirtless men on a boat watch a person water skiing in the distance on a calm lake. | B |
3モデルすべてがウェイクボードを「ウォータースキー」と表現しました。クラウドモデルは正確にウェイクボードと識別しています。
テスト画像4:イタリア・ドロミテのハイキング
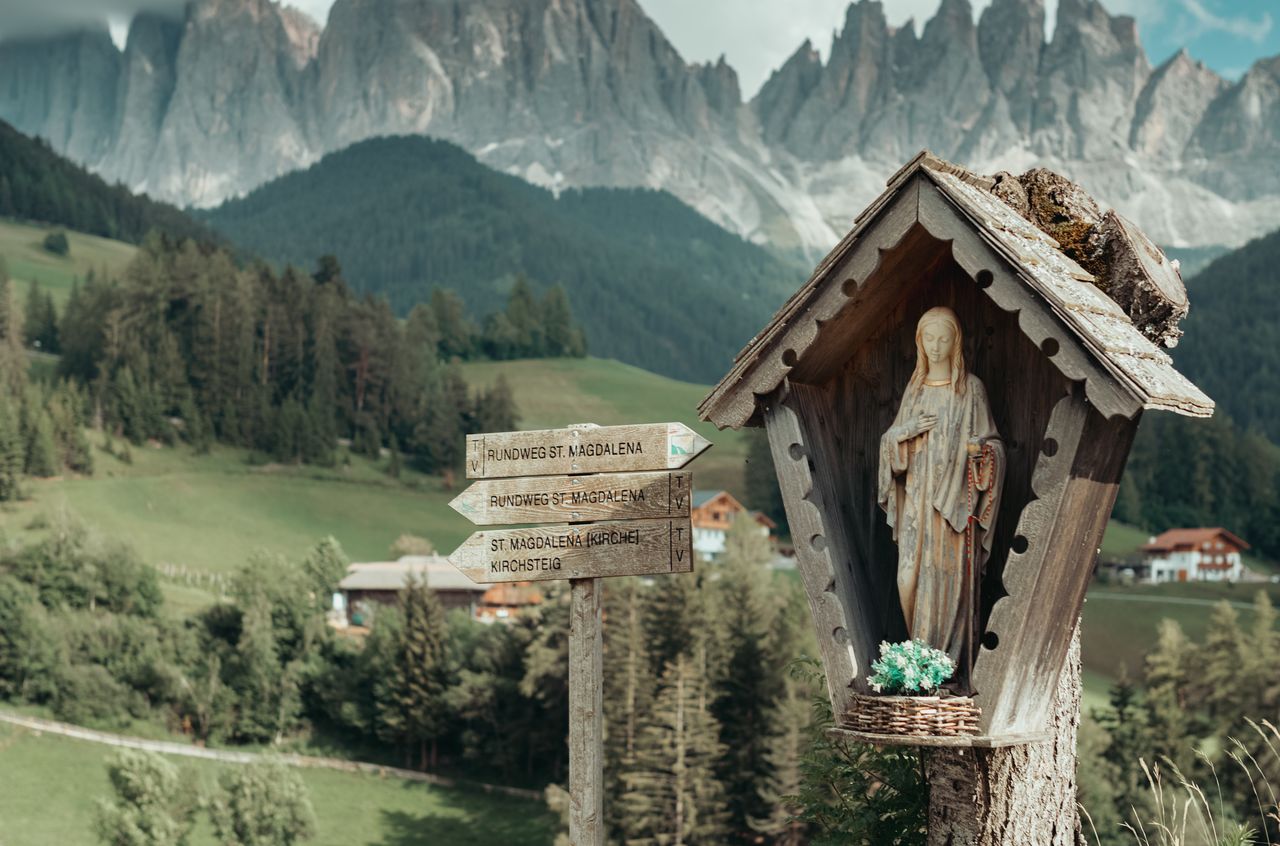
| モデル | 説明文 | 評価 |
|---|---|---|
| Mistral 3.1 (24B) | A wooden statue of a saint is mounted on a post with directional signs pointing to various locations. | C |
| Gemma 3 (27B) | A small wooden shrine with a statue of Mary stands beside a signpost indicating hiking trails in a grassy field. | B |
| Qwen 2.5 VL (32B) | A wooden shrine with a statue of a figure stands on a tree stump, surrounded by a scenic mountain landscape with directional signs in the foreground. | B |
マリア像と正確に識別したのはGemmaだけでした。MistralとGemmaはどちらも背景の山を見逃しています。これは重要な要素のはずです。
テスト画像5:キャンドルライトでバックギャモン
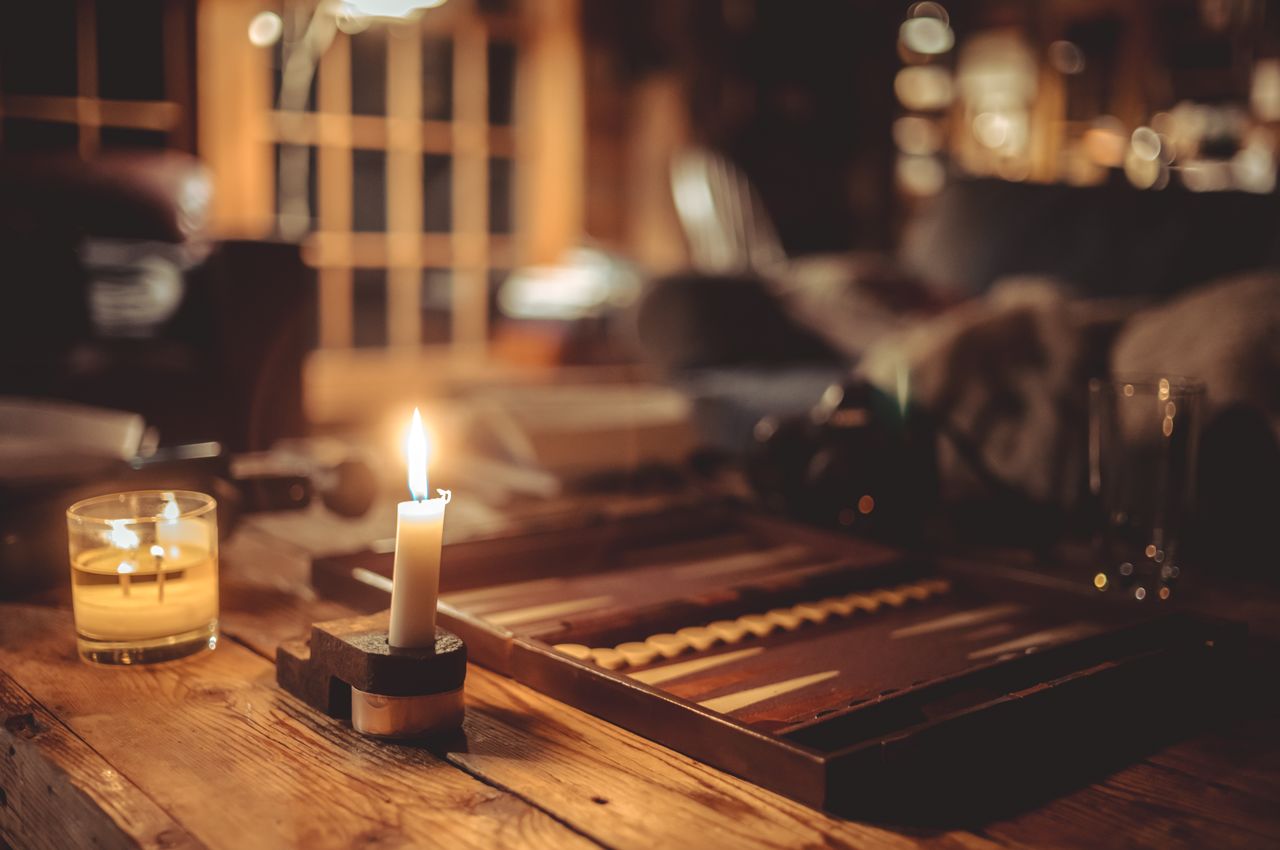
| モデル | 説明文 | 評価 |
|---|---|---|
| Mistral 3.1 (24B) | A lit candle and a glass of liquid are on a wooden table next to a wooden board game. | B |
| Gemma 3 (27B) | A lit candle and glass votive sit on a wooden table, creating a warm, inviting glow in a dimly lit space. | B |
| Qwen 2.5 VL (32B) | A cozy scene with a lit candle on a wooden table, next to a backgammon board and a glass of liquid, creating a warm and inviting atmosphere. | A |
MistralとGemmaはバックギャモンボードを識別できませんでした。正確に識別したのはQwenだけです。Mistralは写真の雰囲気の表現も物足りない結果でした。
モデルの精度まとめ
| モデル | 繰り返し | ハルシネーション | 雰囲気の表現 | 平均スコア | 評価 |
|---|---|---|---|---|---|
| Mistral 3.1 (24B) | なし | なし | 普通 | 3.4/5 | C |
| Gemma 3 (27B) | なし | なし | 良好 | 4.2/5 | B |
| Qwen 2.5 VL (32B) | なし | なし | 良好 | 4.4/5 | B |
総合的にはQwen 2.5 VLが最も優れており、Gemma 3がそれに続く結果でした。
言うまでもなく、これらの結果は少数のテスト画像に基づくものです。また構造化された採点システムを使用しましたが、評価には主観的な判断も含まれます。これは決定的なランキングではなく、いくつかの結論を導き出すには十分という程度のものです。
3つのLLMすべてが繰り返しやハルシネーションを避け、概ね画像の雰囲気を捉えていたのは好ましい点でした。
ローカルモデルはまだミスをします。3モデルすべてがウェイクボードを「ウォータースキー」と表現し、多くが像をマリアと認識できず、交差点を日本と特定できませんでした。クラウドモデルはこれらの細部を正確に捉えています(以前のブログ記事でも示した通りです)。
まとめ
最初の実験から4ヶ月が経ちました。当時テストしたモデルのどれも、大規模なaltテキスト生成に使えるほどの精度には達していませんでした。Llama 3のように可能性は見えるものの、全体的な品質ではまだ及ばないものもありました。
Qwen 2.5 VLやGemma 3といった新しいモデルは、当時のLlama 3と同等のパフォーマンスに達しています。今回のテストでも両モデルは良好な結果を出しました。以前のローカルモデルが苦手としていたハルシネーションや繰り返しなしに、的確で根拠のある説明文を生成できています。
それでも、人間のレビューなしに何千ものaltテキストを生成するほどの信頼性にはまだ届いていません。GPT-4やClaude 3.5よりもミスが多いのが現状です。
私の主な問いは「ローカルモデルは実用的な用途に十分か?」でした。総合最優秀のQwen 2.5 VLも、まだ人間によるレビューが必要です。手動チェックが現実的な小さなバッチには使い始めていますが、大規模な完全自動化には引き続きクラウドモデルを使用しています。信頼性の面でまだ最も優れているからです。
とはいえ、ローカルのビジョン言語モデルは着実に進化しています。私の長期的な目標は、より高い制御性とデータプライバシーを確保できる100%ローカルファーストのワークフローに戻ることです。まだそこには届いていませんが、今回の結果は確かな前進を示しています。
次世代のローカルビジョンモデルが出るまで(あるいは大型モデルを動かせるよう自分のハードウェアをアップグレードするまで)待つつもりです。新しいモデルが登場したら、またテストして報告します。
— Dries Buytaert
この記事は「Comparing local LLMs for alt-text generation, round 2」(投稿日:2025-05-27)の翻訳記事です。
カテゴリ
 カテゴリ
 関連リンク


 Driesブログ記事一覧